
 Под капотом Абукон — статистический движок Конви
Главное об АБ-тестах в Конви
В основе умных АБ-тестов Конви работает Абукон — наш фирменный статистический движок. Он делает современную последовательную статистику понятной маркетологам: без ручных формул, с ясным результатом и открытой научной базой.
Как работает обычный A/B-тест
Допустим, мы хотим понять, помогает ли новая кнопка чаще оформлять заказ.
B выглядит лучше: 6,5% против 5%. Но люди ведут себя случайно. Даже две совершенно одинаковые страницы иногда покажут разные цифры. Статистика отвечает на вопрос: разница достаточно убедительная или пока могла возникнуть случайно?
Что классическому тесту нужно знать до запуска
Нельзя просто сказать «пособираем данные и посмотрим». Сначала калькулятор размера выборки получает четыре числа:
Ожидаемый эффект — ваш прогноз: «думаем, новая кнопка даст +20%».
MDE — минимальный эффект, ради которого вообще стоит менять страницу: «рост меньше +20% не окупит разработку».
Для расчёта выборки важнее MDE. Чем меньшую разницу мы хотим надёжно заметить, тем больше нужно людей: при исходных 5% рост до 5,5% потребует уже около 62 500 посетителей, а рост до 7% — около 4 400.
Сначала мы временно предполагаем: «A и B на самом деле одинаковы». Затем спрашиваем: насколько необычны наши данные при таком предположении?
Маленький p-value означает, что такую разницу трудно объяснить одним шумом. Но p=0,03 не означает «B лучше с вероятностью 97%».
Классический подход статистически корректен. У него лишь одно неудобное правило: размер выборки выбирают заранее, а решение принимают один раз. Это называется fixed horizon — фиксированный финиш.
Почему «подглядывать каждый день» опасно
Маркетологу естественно открыть отчёт утром. Проблема начинается не от самого просмотра, а когда обычный p-value используют как сигнал: «увидели p<0,05 — немедленно остановили тест».
Это похоже на много попыток подбросить монету и показать только удачную серию. Каждая новая проверка — ещё один шанс поймать временный всплеск. Неудачные дни забываются, удачный становится «результатом».
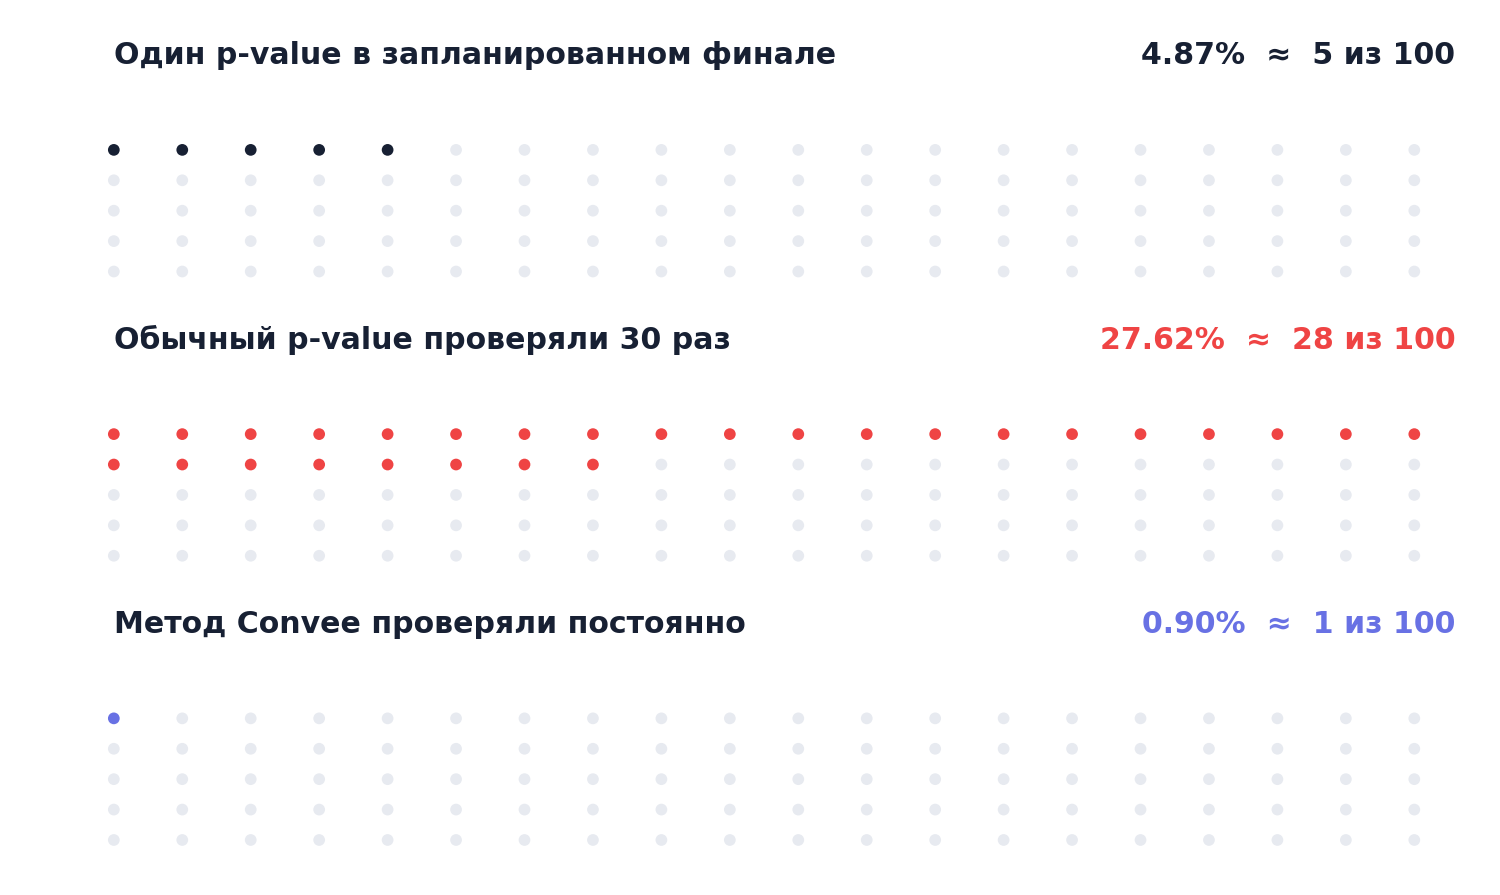
Это не особенность нашей симуляции. Проблема optional stopping подробно разобрана в работе Johari, Pekelis & Walsh.
Что Конви делает иначе
Конви не пересчитывает новый обычный тест при каждом открытии кабинета. Вместо этого ведётся один непрерывный счётчик силы доказательств — E-value.
Откуда вообще взялся E-value?
E-value разработан статистиками и существует независимо от Конви. Его математические корни появились ещё в 1939 году: Жан Вилль показал, как ограничить вероятность того, что «капитал доказательств» случайно достигнет большого значения в любой момент времени.
Зачем это понадобилось: классическая статистика требовала выбрать один финал, а цифровые продукты хотели безопасно наблюдать данные непрерывно и раньше замечать как полезные, так и вредные изменения. Конви применяет этот научный подход в своём движке A/B-тестов.
Нужно ли задавать ожидаемый эффект и размер выборки в Конви?
Конви не использует обещанный эффект и фиксированный размер выборки, чтобы объявить победителя. E-value остаётся корректным при каждом обновлении данных.
Не для формулы Конви, а чтобы до запуска понять, имеет ли тест экономический смысл и хватит ли трафика.
Что MDE даёт при планировании Конви
Обычный расчёт мощности показывает масштаб задачи: для различия 5% → 6% понадобится примерно 16 300 посетителей, то есть около 16 дней при таком трафике.
В текущем Конви при запуске A/B-теста не требуется вводить ожидаемый uplift или заранее фиксировать число посетителей. MDE сейчас не передаётся в статистический движок и не меняет порог E-value. Когда накапливаются первые реальные данные, forecast строит возможные продолжения теста по фактически наблюдаемой картине и показывает обновляемый ориентир по сроку.
Поэтому роли разные: MDE нужен до запуска для ответа «стоит ли вообще начинать?», а forecast после запуска отвечает «когда может появиться подтверждённый результат при текущих данных?».
Это не означает, что Конви «создаёт данные из воздуха». Большой эффект обычно подтверждается быстро, маленький — долго, а при отсутствии разницы победитель может не появиться вообще.
Можно ли остановить тест раньше?
С E-value — да. В классическом тесте обычно заранее выбирают размер выборки и смотрят результат один раз в конце. Если остановиться раньше только потому, что промежуточный p-value стал меньше 0,05, заявленный риск ошибки больше не сохраняется. Исключение — если правила промежуточных остановок были специально заложены в план до запуска.
Объявлять победителя рано: удачный момент остановки не был запланирован.
Если anytime-интервал показывает преимущество B, результат подтверждён — тест можно остановить раньше.
Тест можно прекратить по бизнес-причине, но победителя нет. Это не доказывает, что A и B одинаковы.
Его можно представить как честную бухгалтерию:
- если данные одинаково похожи на A=B и на наличие разницы, E-value остаётся около 1;
- если последовательность конверсий всё лучше объясняется различием, E-value растёт;
- если ранний всплеск не подтверждается, E-value может снова упасть;
- для обычного A/B формальный порог равен 20.
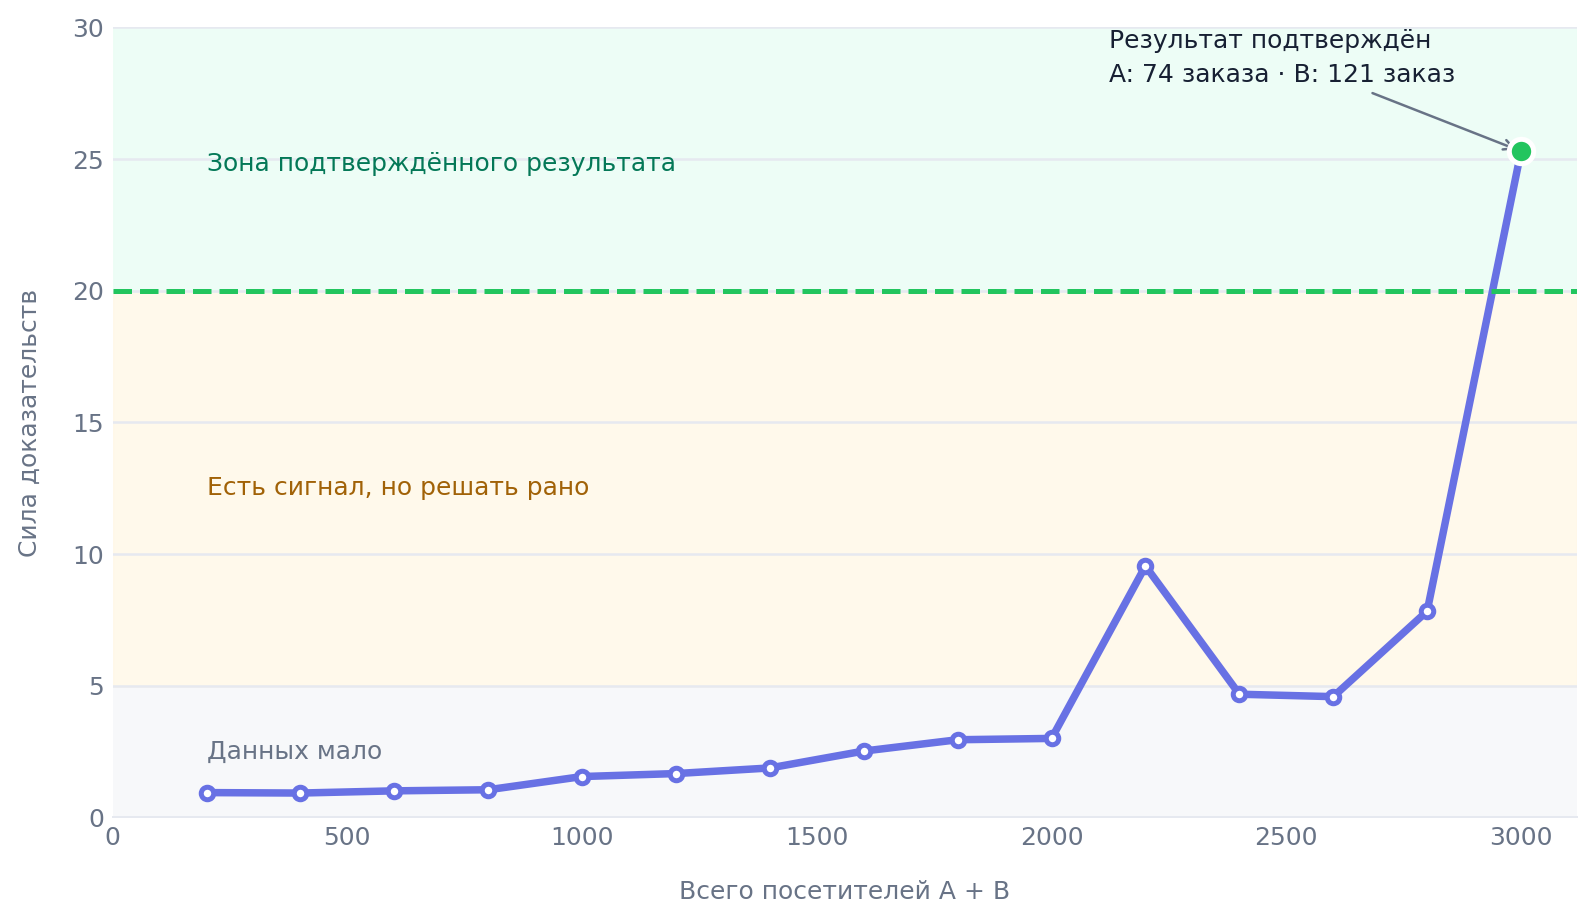
Что увидит пользователь
А если вариантов больше двух?
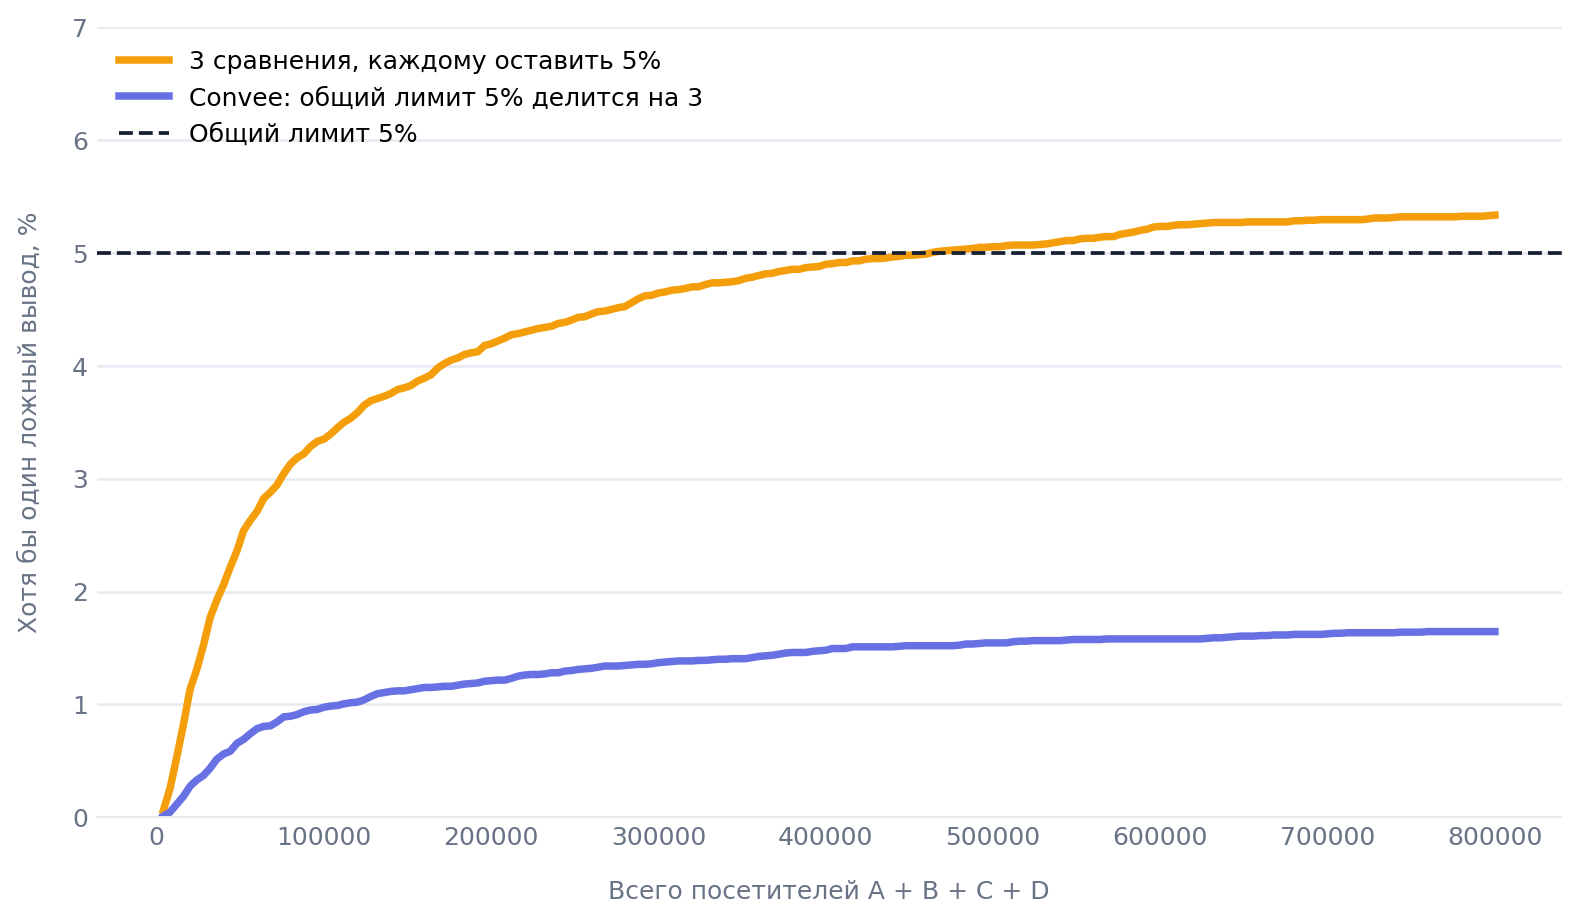
В A/B/C/D мы одновременно задаём три вопроса: лучше ли B, C или D исходного A. Чем больше вопросов, тем больше шансов случайно найти хотя бы одного «победителя».
Конви автоматически делит общий допустимый риск ошибки между сравнениями. Поэтому весь эксперимент, а не каждое удобное сравнение отдельно, сохраняет общий лимит ложного вывода 5%.
А прогноз «когда ждать результат» — это обещание?
Нет. Статистический результат и прогноз — разные вещи.
Отвечает: «доказательств уже достаточно?» Он защищён порогом E-value.
Отвечает: «если текущий трафик и эффект сохранятся, когда мы вероятнее всего накопим доказательства?»
Для прогноза Конви разыгрывает 600 возможных продолжений текущего теста. В одном мире конверсии приходят быстрее, в другом медленнее. Медиана даёт ориентир «около», а 80-й процентиль — осторожную границу «до».
Если поведение аудитории меняется, меняется и прогноз. Сам тест при этом продолжает оставаться корректным.
Что статистика не может починить
Иначе говоря, Конви защищает от случайного шума и выбора удобного момента остановки. Но ни один математический метод не восстановит потерянные события и не сделает честным эксперимент, где правила поменяли после просмотра результата.
На чём это основано
Всё выше — не собственная «магическая формула» Конви. Мы используем опубликованное направление anytime-valid inference: методы, сохраняющие контроль ошибки при непрерывном наблюдении.
Современное систематическое описание E-value как альтернативы p-value и его связи со ставками, отношениями правдоподобия и множественными проверками.
Почему обычный p-value ломается при непрерывном мониторинге и как построить A/B-тест, который можно смотреть постоянно.
Практические последовательные тесты для конверсий и других счётных событий с контролем optional stopping.
E-process как честный капитал и математическая основа выводов, корректных при любом моменте остановки.
Как continuous monitoring и anytime-valid интервалы внедрены в реальную enterprise-платформу Adobe.
Код симуляций и результаты
Все числа на графиках воспроизводимы. В коде зафиксированы seeds, параметры и 20 000 запусков каждого сценария.